Нейронные сети — это вычислительные системы, которые учатся на примерах, а не программируются правилами. Идея позаимствована у мозга: сеть состоит из соединённых «нейронов», каждый из которых получает числа на вход, взвешивает их (умножает на свои коэффициенты), добавляет смещение и пропускает через функцию активации — а обучение сводится к подбору этих весов по примерам по определению Википедии. Такой подход из 1943 года к 2026-му вырос в модели с триллионом параметров, которые пишут код, генерируют видео и отвечают на вопросы. Разбираем, как устроены нейронные сети простыми словами, как они учатся, чем отличаются свёрточные сети от трансформеров и насколько большими они стали к августу 2026 года.
Как устроена нейронная сеть: нейроны, слои, веса
Представьте цепочку людей, передающих записки: каждый читает записку, придаёт ей важность по своему усмотрению (вес) и передаёт дальше. Так же работает нейронная сеть. Минимальная конструкция:
- Входной слой получает данные: числа, описывающие пример (пиксели картинки, слова текста, параметры сделки).
- Скрытые слои обрабатывают их: каждый нейрон вычисляет взвешенную сумму входов (каждое значение умножается на свой вес, результаты складываются, добавляется смещение) и пропускает результат через нелинейную функцию активации — по определению из Википедии.
- Выходной слой выдаёт результат: класс (кот или собака), число (цена квартиры) или следующее слово текста.
Веса — это и есть «память» сети: вся её «мудрость» хранится в миллионах чисел, которые подбираются при обучении. Связи между нейронами организованы слоями, и чем больше слоёв, тем «глубже» сеть — отсюда термин глубокое обучение по статье о deep learning.
Как нейросеть учится: градиентный спуск и ошибка
Обучение — это итеративный процесс исправления ошибок:
- Сеть получает пример и выдаёт ответ.
- Разница между ответом и правильным результатом — ошибка (функция потерь).
- Ошибка «распространяется назад» по слоям, и каждый вес сдвигается на маленький шаг в сторону уменьшения ошибки — это обратное распространение ошибки и градиентный спуск по обзору для начинающих на Хабре.
- Повторение на тысячах примеров (эпох) постепенно «натаскивает» сеть.
Интуитивная аналогия: вы учитесь целиться в темноте — стреляете, видите, куда ушла пуля (ошибка), и чуть сдвигаете прицел (веса). После сотен выстрелов попадание становится стабильным. Именно так работает обучение нейросетей — без знания «правил» предмета, только на парах «вход → правильный ответ».
Краткая история: от перцептрона до трансформеров
История нейронных сетей — это волны энтузиазма и разочарования по хронологии Википедии:
- 1943 — Уоррен Маккаллок и Уолтер Питтс публикуют первую математическую модель нейрона Wikipedia.
- 1957–1958 — Фрэнк Розенблатт создаёт перцептрон — первую обучаемую нейросеть, а затем аппаратную машину Mark I, которая училась отличать треугольники от квадратов перцептрон по Википедии.
- 1969–1993 — «зимы ИИ»: критика перцептронов Мински и Пейперта (1969), отчёт Лайтхилла (1973) и обвал рынка Lisp-машин (1987) обрушивают финансирование по статье об AI winter.
- 2012 — AlexNet побеждает в конкурсе ImageNet с ошибкой 15,3% против 26,2% у второго места: 60 млн параметров, обучение на GPU — начало эры глубокого обучения AlexNet по Википедии.
- 2017 — статья «Attention Is All You Need» представляет архитектуру трансформер — полностью на механизме внимания, без рекуррентных слоёв arXiv.
- 2020 — GPT-3 с 175 млрд параметров показывает, что масштаб решает: модель учится задачам по нескольким примерам по Википедии.
Как трансформеры понимают текст: внимание простыми словами
Почему именно трансформеры стали основой всех современных языковых моделей? Ключевая идея — механизм внимания. Рекуррентные сети читали текст по одному слову, запоминая предыдущее состояние; трансформер обрабатывает всю последовательность сразу и сам решает, на какие слова «обратить внимание» при генерации каждого следующего по статье «Attention Is All You Need».
Простая аналогия: читая «Аня передала Кате мяч, потому что ей было холодно», человек понимает, что «ей» относится к Кате, а не к Ане, — по смыслу, а не по порядку слов. Внимание делает то же самое: для каждого слова модель вычисляет «веса важности» остальных слов. Благодаря этому трансформеры удерживают длинные связи — через десятки страниц текста — и учатся на огромных объёмах данных параллельно, а не последовательно.
Что такое параметры модели и почему их считают
«Параметры» — это и есть веса нейронной сети, о которых мы говорили выше: числа, которые подбираются при обучении. Когда говорят «модель на 175 млрд параметров», это значит, что в сети 175 млрд обучаемых чисел — и каждое хоть чуть-чуть влияет на ответ.
Практический смысл параметров в 2026 году:
- Больше параметров — больше «знаний», но и больше затрат на обучение и запуск. Поэтому современные модели используют MoE: суммарно триллионы параметров, но на каждый запрос активируется лишь десятки миллиардов по статье о смеси экспертов.
- «Активные параметры» — честная метрика стоимости вызова: у DeepSeek V4-Pro это ~49 млрд из 1,6 трлн официальный анонс.
- Качество не сводится к параметрам: большее значение имеют данные обучения и архитектура. GLM-5 обучена на 28,5 трлн токенов документация Z.ai — и это объясняет её уровень больше, чем 744 млрд параметров.
Мифы о нейронных сетях
Три популярных заблуждения, с которыми сталкиваются новички:
- «Нейросеть думает, как человек». Нет: она вычисляет вероятности продолжений. Умные ответы — результат обучения на огромных данных, а не мышления в человеческом смысле.
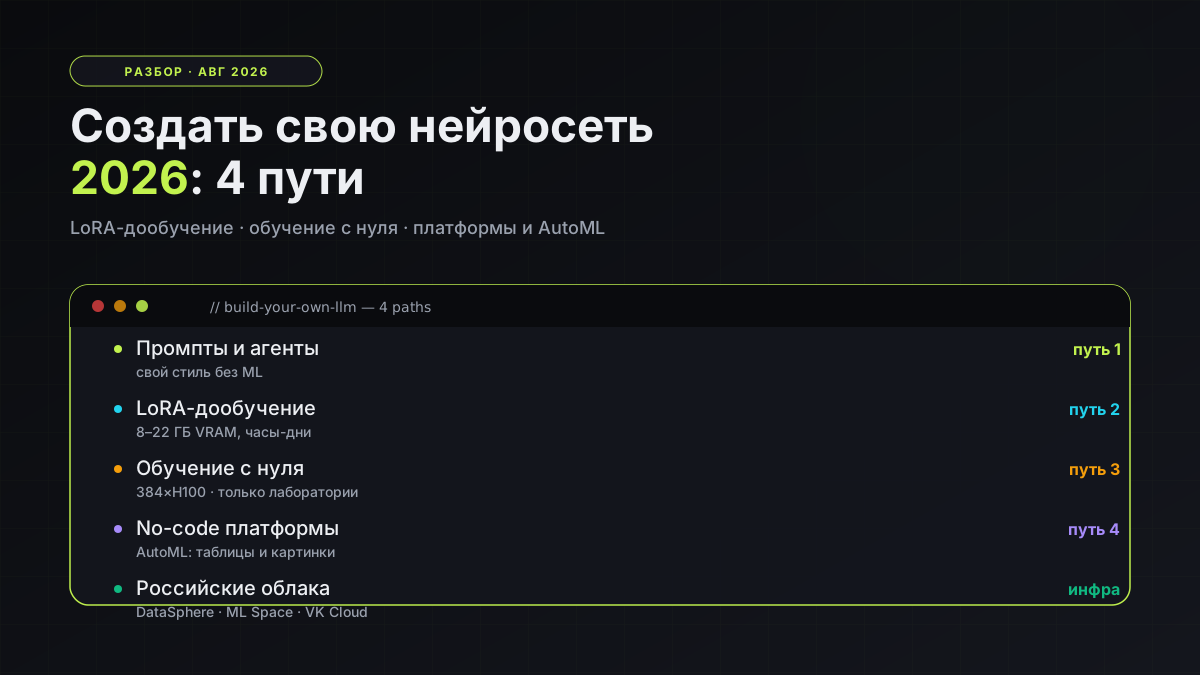
- «Нейросеть обучается в процессе общения». Обычные чаты не дообучаются на ваших диалогах: разговор живёт только в пределах сессии, а следующая начинается «с чистого листа». Дообучение — отдельный процесс, о нём в гайде по созданию своей нейросети.
- «Нейросеть знает всё». Она знает только то, что было в обучающих данных до определённой даты; актуальную информацию ищет через инструменты — поиск и RAG разбор RAG.
Какие бывают нейронные сети
| Тип | Что делает | Где применяется |
|---|---|---|
| Свёрточные (CNN) | Обрабатывают данные с сеточной структурой через обучаемые фильтры | Распознавание изображений, видео Wikipedia |
| Рекуррентные (RNN, LSTM) | Учитывают предыдущее состояние — «память» | Текст, речь, временные ряды Wikipedia |
| Трансформеры | Механизм внимания: учитывают все части последовательности сразу | Языковые модели: ChatGPT, DeepSeek, GigaChat |
| MoE (смесь экспертов) | Гейтинг-модель направляет запрос только к части «экспертов» сети | Экономия вычислений в больших LLM Wikipedia |
Современные языковые модели — это трансформеры, часто в архитектуре MoE: огромное суммарное число параметров при умеренной стоимости вызова, потому что на каждый запрос активируется лишь малая часть сети по статье о Mixture of experts.
Насколько большими стали нейросети в 2026
Масштабы современных моделей — по официальным документациям:
- DeepSeek V4-Pro (релиз 13 августа 2026) — около 1,6 трлн параметров всего, ~49 млрд активных на токен, контекст 1 млн токенов, вывод до 384 тысяч токенов официальный анонс.
- GigaChat 3.5 Ultra (Сбер) — 432 млрд параметров, 28 млрд активных, нативное обучение в FP8, открытые веса (MIT) статья Сбера на Хабре.
- GLM-5 (Z.ai) — около 744 млрд параметров, ~40 млрд активных, предобучение на 28,5 трлн токенов документация Z.ai.
Для сравнения с масштабами обучения: полное обучение DeepSeek-V3 (671 млрд параметров) стоило 5,576 млн долларов и 2,788 млн GPU-часов техотчёт arXiv. Это объясняет, почему только крупные лаборатории и корпорации обучают флагманов — а всё остальное строится на дообучении открытых моделей, о чём мы писали в гайде о создании своей нейросети.
Где нейросети работают уже сегодня
Нейронные сети давно не экзотика, а производственная инфраструктура. Показательный пример из России: в ЦИАН единый контур генеративного ИИ отвечает за поиск и рекомендации, ИИ-модерация держит чистоту 2,1 млн объявлений, а более 35% кода платформы пишет нейросеть по интервью ИТ-директора ЦИАН для CNews. Общий список применений — распознавание образов, обработка языка, медицина, транспорт, рекомендательные системы по обзору Википедии.
Попробовать нейронную сеть в деле можно бесплатно: чаты Алисы и GigaChat, открытые DeepSeek и GLM — все доступны из России. А если хочется не просто спросить, а получить работу: AI-агенты на AgentHere используют те же модели, но с инструментами — документами, изображениями, автоматизацией. Первые 1 000 000 токенов — бесплатно при регистрации.
Узнайте больше
- Что такое AI-агенты — как модели превращаются в исполнителей
- Что такое MCP (Model Context Protocol) — как нейросети подключают инструменты
- Можно ли создать свою нейросеть — пути от LoRA до обучения с нуля
- Что умеет нейросеть в 2026 — задачи современных моделей
Источники
- Нейронная сеть — Википедия
- Artificial neural network — Wikipedia
- Deep learning — Wikipedia
- History of artificial neural networks — Wikipedia
- Перцептрон — Википедия
- AI winter — Wikipedia
- AlexNet — Wikipedia
- Attention Is All You Need — arXiv
- GPT-3 — Wikipedia
- Convolutional neural network — Wikipedia
- Recurrent neural network — Wikipedia
- Mixture of experts — Wikipedia
- DeepSeek-V4-Pro GA — официальные доки
- Сбер о GigaChat 3.5 Ultra — Хабр
- GLM-5 — документация Z.ai
- DeepSeek-V3 Technical Report — arXiv
- Нейросети для начинающих — Хабр
- CNews: интервью ИТ-директора ЦИАН
- Applications of artificial intelligence — Wikipedia