Что отдавать агенту, а что оставить себе?
ИИ для программистов в 2026 — это не подсказки в редакторе, а исполнитель задач. Агент читает папку проекта, правит файлы, запускает тесты, показывает, что изменил. Отдавайте ему пять вещей: тесты и починку упавших, рефакторинг по заданным правилам, разбор незнакомого кода, миграции и одноразовые скрипты, черновики документации. Не отдавайте три: архитектурные решения, приоритеты и всё, что связано с секретами и продакшен-доступами.
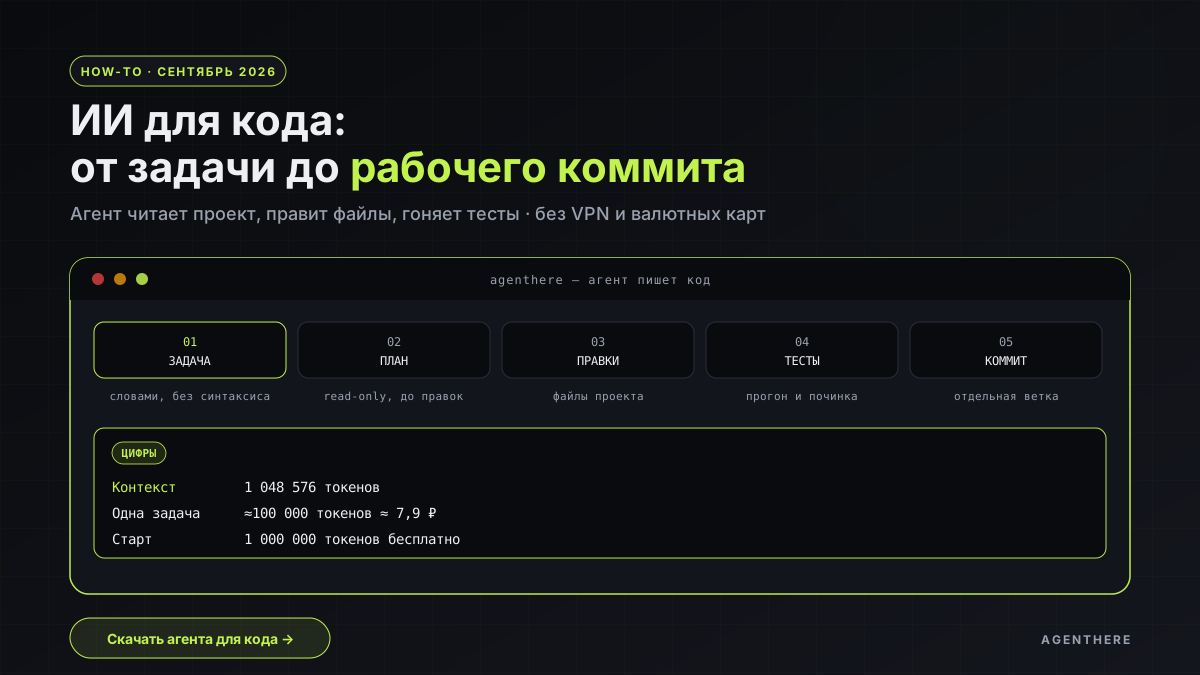
Цифры для ориентира. Одна задача ≈ 100 000 токенов ≈ 7,9 ₽, контекст — 1 048 576 токенов, в одну сессию помещается модуль целиком, а не один файл. Медианная зарплата IT-специалиста в России в первом полугодии 2026 — 191 000 ₽ (Хабр, выборка 45 226 зарплат). Час вашего времени дороже дня работы агента.
Граница проходит там, где есть формальный критерий готовности. Тест зелёный или красный, линтер молчит или ругается, типы сходятся или нет. Агент силён в задачах с такой проверкой. Программирование с ИИ начинается с этого вопроса: чем вы проверите результат. ИИ помощник программиста в такой схеме — исполнитель, а не автор решений. Там, где критерий внешний — что важнее для бизнеса, что можно сломать, кого предупредить, — он оптимизирует локально и выдаёт правдоподобный ответ.
Нейросеть для программистов обычно сравнивают по качеству ответов в чате. В работе критерий другой: дотягивает ли она задачу до проверки — прогона тестов, диффа, зелёного линтера.
Таблица: задача, делегировать ли, почему, что проверить после
| Задача | Делегировать | Почему | Что проверить после |
|---|---|---|---|
| Юнит-тесты и починка падений | Да | Критерий готовности формальный: набор тестов либо зелёный, либо нет | Граничные случаи — пустой ввод, отрицательные числа, таймауты; не подогнаны ли тесты под текущее поведение |
| Рефакторинг по заданным правилам | Да | Механическая работа, правила задаются заранее | Публичные сигнатуры и внешнее поведение не изменились; прогон тестов до и после правки |
| Разбор незнакомого кода | Да | Читает десятки файлов подряд и не устаёт | Ссылки вида путь:строка — открыть и сверить с кодом |
| Черновик документации и README | Да | Текст правится одной командой, риск низкий | Утверждения про поведение, ограничения и гарантии — их знает только автор |
| Миграции и backfill-скрипты | Да, с оговоркой | Логика описывается точно, но запуск трогает данные | --dry-run на копии, батчи, идемпотентность, план отката |
| Архитектура и выбор стека | Нет | Решение зависит от продукта, бюджета и команды, а не от кода | — |
| Приоритеты: что делать первым | Нет | Это про бизнес, а не про реализацию | — |
| Секреты, ключи, продакшен-доступы | Нет | Ошибка необратима, а инъекция промпта превращает агента в канал утечки | — |
Пять строк «да», три «нет» — и это не значит, что остальное можно отдать не глядя. Отдельным правилом, поверх таблицы: коммит в main без ревью не делается ни человеком, ни агентом. В опросе SkillStaff (1000+ респондентов, сентябрь 2026) 74% ИТ-специалистов используют ИИ ежедневно или несколько раз в неделю, для написания кода его применяют только 25%, для поиска багов и автотестов — 29%. Опрос K2 Cloud и Хабра (872 анкеты) даёт другую картину: написание кода — 59,1% задач, документация — 51,1%, прототипы — 43,7%. Расхождение объяснимое. Написать код с ИИ пробовали почти все, а системно отдавать ему тесты и разбор чужого кода — единицы. Отдача выше всего именно там.
Какие сценарии работают в первый же день?
Пять формулировок, которые можно скопировать в диалог с агентом. Общее у них одно: назван файл, назван критерий готовности, сказано, чего делать нельзя.
Начните с модуля, который никто не покрывал тестами. Тут выигрыш заметен сразу, а риск минимальный: поведение кода не меняется.
В billing/legacy_calc.py функция apply_discount не покрыта тестами. Напиши тесты в tests/test_legacy_calc.py: обычный случай, нулевая сумма, отрицательная сумма, скидка 100%. Саму функцию не меняй — если найдёшь баг, опиши его комментарием к тесту. Готово, когда pytest tests/test_legacy_calc.py -q проходит.
Второй сценарий — рефакторинг с фиксированным правилом. Правило задаёт человек, исполнение — агент.
Разбей process_order в orders/service.py на три функции: валидация, расчёт, запись в базу. Публичные сигнатуры и внешнее поведение не меняй. После правки прогони pytest tests/orders -q и покажи git diff.
Третий — карта чужого участка кода. Это то, на что уходит день при онбординге и чего потом не хватает в вики.
Объясни, как в этом репозитории устроена авторизация: где выдаётся токен, где проверяется, какие таблицы читаются. Результат — docs/auth-map.md со ссылками формата путь:строка. Код не правь.
Четвёртый — флейки-тест. Нудная работа: прогнать одно и то же тридцать раз и прочитать стек-трейсы. Здесь важно запретить правки, иначе агент «починит» симптом.
test_payment_timeout падает примерно раз в двадцать прогонов. Прогони его 30 раз, собери стек-трейсы падений в /tmp/flaky.log и предложи гипотезу с доказательством из лога. Правки пока не вноси.
Пятый — техдолг по типам и линтеру. Ограничивайте объём: задача «почини 340 ошибок mypy» расползается на часы, а «первые пятьдесят, одна правка — один коммит» заканчивается предсказуемо.
mypy --strict выдаёт в пакете core/ 340 ошибок. Почини первые 50, начиная с самых простых. Одна правка — один коммит. Каждые десять коммитов прогоняй pytest tests/core -q и останавливайся, если стало красным.
Anthropic в экономическом индексе оценивает успешность задач по разработке в 61% против 78% для личных задач. Причина в том, что в разработке дороже всего стоит нечёткая задача. Агент, который получил «приведи код в порядок», приведёт его в свой порядок.
Сколько это стоит и где взять бесплатные токены?
Если искать ИИ для программистов бесплатно, самый короткий путь — стартовый миллион токенов. 1 000 000 токенов дают один раз при регистрации после подтверждения email. Это не ежемесячная квота, а разовый бонус. Анонимный чат без регистрации ограничен пятью сообщениями в час, историю он не хранит.
Дальше — пакеты. Starter — 300 ₽ за 2 000 000 токенов, Plus — 900 ₽ за 7 000 000, Pro — 2 250 ₽ за 18 000 000, Scale — 8 250 ₽ за 70 000 000. Полный список — на /pricing. Подписок нет: платёж разовый, автопродления нет, токены не сгорают. Первые 48 часов после регистрации новичку считают цену по скидке −33%, то есть 200, 600, 1 500 и 5 500 ₽. Тариф Scale даёт −33% навсегда.
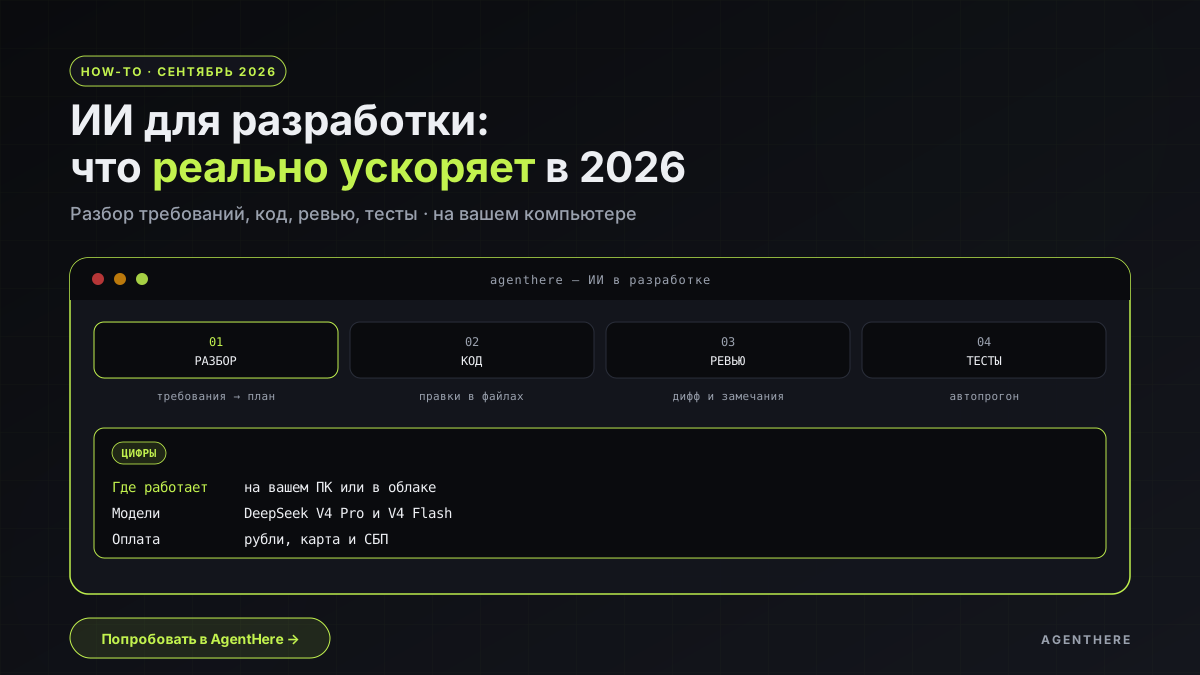
Про модели коротко, потому что здесь чаще всего путаница. На десктопе и в веб-чате доступны две модели — deepseek-v4-pro и deepseek-v4-flash, по умолчанию Flash. Через API добавляются glm-5.2 и glm-4.7-flash. Claude и GPT платформа не предоставляет: запрос с именем модели claude-* или gpt-* вернёт 404 со списком доступных. Выходной лимит — 32 768 токенов, входной контекст — 1 048 576.
Есть и способ не платить за модель вообще: нейронка для программирования не обязана быть облачной. Движок десктопного клиента собран на открытом форке opencode, который официально настраивается на локальные модели через Ollama, LM Studio и llama.cpp (opencode.ai/docs/providers). Качество на компактной локальной модели ниже, чем на DeepSeek V4, но для автодополнения и мелких правок хватает, и код не покидает машину.
Как это делать в AgentHere
Два пути: приложение для тех, кто работает с файлами проекта, и API для тех, кто живёт в терминале и своих редакторах.
Десктоп. Агент читает код и документы в папке проекта, вносит правки, показывает, что изменил, разбивает задачу на шаги и помнит ваши правила.
- Зарегистрируйтесь на /signup и подтвердите email — на баланс придёт 1 000 000 токенов.
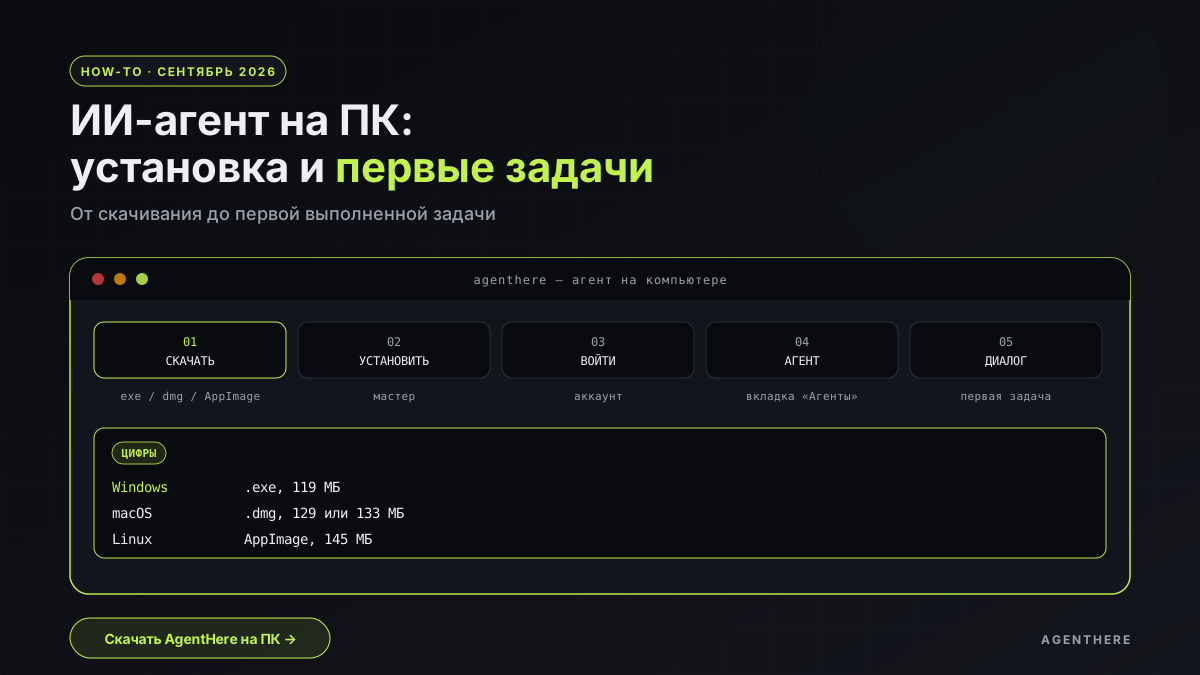
- Скачайте сборку на /download: Windows 10+, macOS 12+, Linux x64. Для Linux это AppImage, перед запуском
chmod +x agenthere-electron-linux-x86_64.AppImage. Установщик для Windows не подписан, SmartScreen покажет предупреждение: «Подробнее» → «Выполнить в любом случае». - Войдите в аккаунт и откройте вкладку «Агенты» — там ставится агент «Персональный помощник». Своего настройте в /agents, это занимает минут десять.
- В диалоге укажите папку проекта и отдайте первую задачу из тех, что разобраны выше. Лучше всего зайдёт тесты на модуль без покрытия: критерий готовности виден сразу.
- Правила проекта — команды сборки и тестов, конвенции, запреты — вынесите отдельным файлом в корень репозитория. Агент читает такие файлы перед работой, и качество правок заметно растёт. Подробнее про права, ветки и ревью — в отдельном разборе как настроить ИИ-агента для кода.
API и MCP. Ключ создаётся в кабинете разработчика на /dashboard/developer: тип proxy, начинается с ah_, показывается один раз.
- OpenAI-совместимый протокол: базовый URL
https://agenthere.ru/v1, заголовокAuthorization: Bearer ah_.... Подходит для Cursor, Cline, Continue, Aider, Zed и opencode. - Anthropic-совместимый протокол: базовый URL
https://agenthere.ru/anthropic, заголовокx-api-key: ah_.... Для инструментов, которые понимают только этот протокол. - Лимиты одного ключа: 60 запросов в минуту и 100 000 токенов в день. Каталог моделей и остальные параметры — в разделе для разработчика и в /docs.
Один запрос из терминала:
curl https://agenthere.ru/v1/chat/completions \
  -H "Authorization: Bearer ah_ВАШ_КЛЮЧ" \
  -H "Content-Type: application/json" \
  -d '{"model":"deepseek-v4-pro","messages":[{"role":"user","content":"Объясни, что делает функция parse_config в config.py"}]}'
MCP-сервер живёт на https://agenthere.ru/api/mcp (Streamable HTTP и SSE) и отдаёт 57 инструментов: анализ изображений и видео, транскрибация, генерация картинок и видео, веб-поиск, чтение страниц, создание сайтов, таймеры, диагностика аккаунта. Подключается к любому клиенту с поддержкой MCP — синтаксис подключения в документации. Правило простое: MCP-сервер имеет ровно столько доступа, сколько ему дали.
Пять задач, которые стоит отдать агенту на этой неделе
- Модуль с наименьшим покрытием. Отдайте его целиком: «напиши тесты на этот файл, покрой граничные значения, поведение не меняй». Проверка — прогон и чтение диффа.
- Линтер и типы.
ruff check --fixиmypy --strict— рутина, в которой агент не устаёт. Ограничьте объём: не «почини всё», а «первые пятьдесят ошибок, одна правка — один коммит». - Карта участка кода. Пусть напишет
docs/имя-модуля.mdсо ссылками видапуть:строка. Через неделю вы сами будете ей пользоваться. - Один флейки-тест. Прогон в цикле и разбор логов — двадцать минут работы, из которых ваших пять.
- Один старый TODO из трекера. Отдайте как черновик: «предложи три варианта решения с плюсами и минусами, код не пиши». Выбор останется за вами.
Больше половины этих задач закрывается за один вечер. Если начать с одной — берите первую: она даёт самый быстрый видимый результат.
Когда это не сработает
Архитектура не делегируется. Агент видит только код. Он не знает про контракт с партнёром, про то, что модуль выводят из эксплуатации через полгода, про то, что команда не умеет в Kubernetes. GitHub предупреждает прямо: «архитектурный дрейф может накапливаться быстрее без правильных ограничителей». Решение о структуре принимает человек, агент его исполняет.
Приоритеты тоже остаются у человека. Что делать первым — вопрос денег и договорённостей, а не качества кода. Модель тут не имеет ни контекста, ни ответственности.
Секреты и продакшен. Опасностей две, и они разной природы. Первая — обычная ошибка: агент с правом на прод-базу выполнит DROP так же уверенно, как SELECT. Вторая — инъекция: скрытую инструкцию можно спрятать в issue, в комментарии, в тексте страницы, которую агент читает. OpenAI описывает риск для MCP без обиняков: «вредоносный сервер может эксфильтровать чувствительные данные из всего, что попадает в контекст модели». Инъекция аргументов доводит агентов с «безопасными» командами до выполнения произвольного кода — CVE-2025-54795 и GHSA-534m-3w6r-8pqr. Отсюда два правила из документации Anthropic: запрет приоритетнее разрешения (широкое «запрещено» перебивает узкое «разрешено» в любом режиме), а песочница ограничивает файлы и домены, причём следит за этим операционная система, а не модель. GitHub в локальной песочнице Copilot CLI идёт дальше — запрет по умолчанию.
Отдельный случай — команда без тестов и CI. DORA 2025: 90% техспециалистов используют ИИ, больше 80% отмечают рост продуктивности, но 30% почти или совсем не доверяют сгенерированному коду. ИИ работает усилителем — множит и сильные стороны процесса, и слабые. Там, где нет тестов и ревью, агент уверенно ломает соседний модуль, и узнаёте вы об этом не сразу.
Про «почти правильно» есть отдельная статистика. Stack Overflow 2025: 66% разработчиков раздражают решения, которые «почти правильные», 45% тратят время на отладку сгенерированного кода, 46% не доверяют точности моделей. Час, потраченный на чтение диффа, дешевле часа отладки. И да, 52% не используют агентов вообще или обходятся простыми инструментами, а 87% обеспокоены точностью автономных агентов.
Цепочка поставок. В марте 2026 подменённый пакет LiteLLM на PyPI пролежал около трёх часов и был скачан почти 47 тысяч раз. Заражённый пакет Nx заставлял локальные ИИ-CLI собирать файл с секретами. Если агент предлагает поставить зависимость — откройте реестр и проверьте имя пакета руками.
И последнее, что ломает делегирование, — команда без правил. Чёткие гайдлайны по ИИ и перечень разрешённых инструментов есть только у 30% компаний. Без них каждый делегирует по-своему, и ревью превращается в лотерею. 4% российских компаний-разработчиков уже зафиксировали атаки на рабочие ИИ-инструменты, ещё 22% их не отслеживали.
Что делать с этим списком? Не отказываться от агента, а вынести границы в конфигурацию: рабочая копия вместо продакшена, отдельная ветка на задачу, запрет на чтение файлов с ключами, обязательный дифф перед коммитом. Тогда большинство пунктов выше перестаёт быть риском и становится просто правилом работы.
Источники
- DORA 2025: противоречия вокруг ИИ в разработке и полный отчёт
- Stack Overflow Developer Survey 2025: ИИ
- Anthropic Economic Index, январь 2026 и влияние ИИ на разработку
- GitHub: как ИИ меняет выбор разработчиков, данные Octoverse
- Anthropic: права агента, песочница, безопасность
- GitHub: локальная песочница Copilot CLI и риски и защита
- OpenAI: коннекторы MCP и prompt injection
- Хабр: инъекция аргументов, CVE-2025-54795 и GHSA-534m-3w6r-8pqr
- Хабр: подмена пакета LiteLLM на PyPI и заражённый пакет Nx
- CNews: SkillStaff — 74% ИТ-специалистов используют ИИ и 95% Java-разработчиков
- Хабр: K2 Cloud — топ задач для ИИ в ИТ
- Хабр: медианная зарплата IT-специалистов в 1П 2026
- РБК: атаки на рабочие ИИ-инструменты
- opencode: подключение провайдеров и локальных моделей
- Model Context Protocol: введение и Хабр: сколько доступа у MCP-сервера
- DeepSeek API: цены
Дальше по теме: что именно нужно настраивать перед первой задачей, как агент проверяет код тестами, обзор нейросетей для программирования, какие ИИ-клиенты для кода выбирают и базовый разбор ИИ для кода.
Начать можно сегодня: зарегистрируйтесь, скачайте десктоп и отдайте агенту один модуль без тестов. Критерий готовности будет виден сразу — зелёный pytest.