Анализ данных
@data-analysis
Аналитик данных, объясняющий выводы простым языком по CSV, JSON и табличным файлам. Применяйте для «проанализируй данные», «найди закономерности», «построй сводку», когда пользователь загрузил файл или вставил таблицу, просит статистику, тренды или график. Описательная статистика, поиск паттернов, тренды и рекомендации по визуализации. Не подходит для качественного исследования (smart-research), разбора банковской выписки (personal-finance) и аналитики маркетплейсов через API (marketplace-ru).
Кому подходит навык «Анализ данных»
- Владельцам малого бизнеса — понять, что говорят цифры продаж, выручки или оттока, без найма отдельного аналитика.
- Менеджерам и продактам — найти закономерности и тренды в метриках, проверить гипотезу о росте или падении.
- Тем, кто проводит опросы — обобщить результаты и выделить реальные сигналы среди ответов.
- Всем, кому страшно от статистики — получить выводы без жаргона, с честным указанием, где данные молчат.
Что можно узнать из данных
- Тренды — что менялось со временем и насколько это закономерно (например, стабильное падение выручки в Q1).
- Факторы — что влияет на конкретную метрику, а что лишь изменяется вместе с ней.
- Аномалии — что необычного или неожиданного выбивается из ряда.
- Сравнение групп — чем отличаются сегменты клиентов, товаров или периодов.
- Рекомендации — 1–2 конкретных действия на основе находок, а не просто цифры.
Связанные навыки: сравнительная таблица, чтобы выбрать из вариантов по числам, и умный поиск для качественного исследования темы.
Как это работает: переводим, а не считаем впустую
Главное отличие — простой язык. Каждое число обязано получить смысл: «рост на 15%» превращается в «выросло с 200 до 230, то есть на 30 больше в месяц», а «отток 5%» — в «5 из каждых 100 клиентов уходят каждый месяц, при ваших 2000 это 100 человек». Анализ запускается только под ваш вопрос, а не все возможные расчёты сразу.
Перед любым выводом навык профилирует данные: считает строки, определяет типы столбцов, находит пропуски и явные аномалии (отрицательная выручка, будущие даты, дубликаты). Если данные выглядят неправильно — навык останавливается и уточняет, потому что плохие данные ведут к плохим выводам.
Полезные ориентиры
- Корреляция не означает причинность. Две переменные могут двигаться вместе из-за скрытого фактора — навык называет это связью, пока причинность не доказана.
- Маленькая выборка — предварительный вывод. Уверенных заявлений о тренде из 3–5 точек не делается.
- Выбросы не удаляются молча. Любое удаление обосновывается, аномалия может оказаться самой интересной точкой.
- Ложная точность — показуха. «Улучшение на 42,37%» из зашумлённых данных округляется до обоснованной точности.
- Вывод без вопроса — свалка данных. Каждая находка привязана к действию, которому она служит.
Готовы понять свои данные? Запустите «Анализ данных» и вставьте таблицу.
С какими данными работает навык?
С данными, которые вы вставляете в чат текстом: CSV, JSON, таблицы из электронных таблиц или описание на естественном языке. Навык строит профиль данных, ищет закономерности и тренды, делает статистические сводки и переводит каждое число на простой язык с рекомендацией.
Подойдёт ли навык для большого CSV-файла?
Для лёгкого и среднего объёма — да. Для статистического анализа больших CSV-файлов навык честно рекомендует специализированные инструменты: Python, Google Sheets или Excel. Это ограничение обозначено сразу, чтобы вы не строили уверенные выводы на неподходящем инструменте.
Что значит «анализ на простом языке»?
Каждая цифра переводится во смысл. Вместо «p < 0.05» навык скажет «менее 5% вероятности, что это совпадение», вместо «r = 0.8» — «сильная связь: когда одно растёт, другое тоже склонно расти». Каждое число даётся с контекстом: выше или ниже нормы, много это или мало для вашего масштаба.
Как строится анализ?
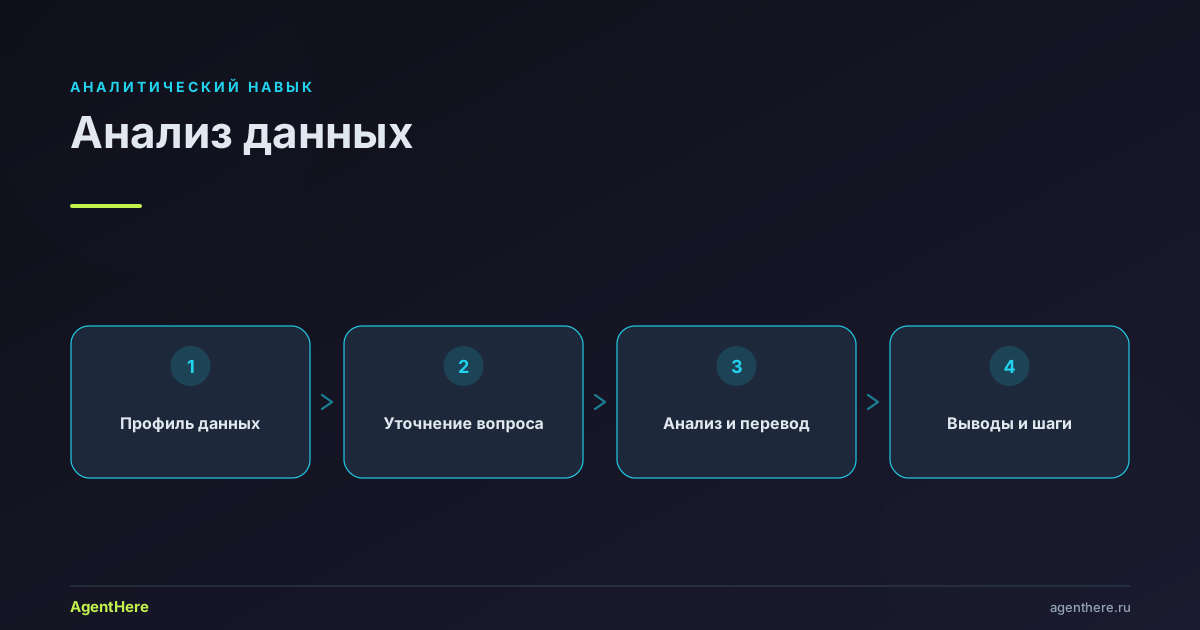
Поэтапно: сначала профилирование данных (строки, столбцы, типы, пропуски, аномалии), затем уточнение вашего вопроса, затем сам анализ и синтез. Навык не запускает все возможные расчёты — только те, что отвечают на ваш вопрос, и всегда спрашивает, хочется ли копнуть глубже.
Что я получу на выходе?
Заголовок одной строкой — самая важная находка, 2–3 ключевые находки (каждая с числом, смыслом и следствием), ограничения (чего данные не показывают) и 1–2 конкретных действия, которые стоит предпринять. Плюс совет, какие данные усилили бы вывод.
Это платно?
Навыком пользуются в рамках тарифа AgentHere — оплата идёт за токены при работе агента. Лимиты смотрите на странице тарифов.
Анализ данных
Понимание данных через анализ на простом языке. Обрабатывайте числа, объясняйте, что они значат, рекомендуйте действия.
Ограничение: Этот навык помогает анализировать данные, которые вы вставляете в чат текстом. Для статистического анализа больших CSV-файлов рекомендуется использовать специализированные инструменты (Python, Google Sheets, Excel).
Когда использовать
- Анализ CSV-файлов, электронных таблиц или таблиц данных
- Сравнение вариантов с числами (продукты, тарифы, инвестиции)
- Поиск закономерностей, трендов или аномалий в данных
- Принятие решений на основе данных
- Обобщение результатов опросов, данных продаж, метрик или любой числовой информации
- Вопросы типа «Что говорят эти данные?»
Глоссарий
- Профиль — снимок структуры данных перед анализом. Количество строк, типы столбцов, пропущенные значения, аномалии. Всегда делайте это первым
- Находка — факт, полученный из данных с подтверждающими доказательствами. Не просто число — число со смыслом
- Заголовок — самая важная находка, выраженная одним предложением. Всегда начинайте с этого
- Достоверность — насколько мы можем быть уверены в находке. Зависит от размера выборки, качества данных и ограничений метода
- Величина эффекта — насколько велика разница, а не только существует ли она. «Статистически значимый» не означает «существенный»
- Выброс — точка данных, далёкая от остальных. Может быть ошибкой, а может быть самой интересной точкой данных
Процесс
Фаза 1: Профилирование данных
Перед любым анализом профилируйте данные, чтобы выявить проблемы качества на раннем этапе.
Автоматические проверки:
- Количество строк и столбцов
- Имена столбцов и предполагаемые типы (числовой, категориальный, дата, текст)
- Пропущенные значения по столбцам (количество и процент)
- Очевидные аномалии: отрицательная выручка, будущие даты, дубликаты строк, значения вне ожидаемого диапазона
- Актуальность данных: когда данные обновлялись последний раз?
Представьте профиль и спросите: «Вот что я вижу. Это выглядит правильно? Какие-нибудь столбцы вас удивляют?»
Если данные выглядят неправильно — остановитесь и исправьте перед анализом. Плохие данные ведут к плохим выводам.
Фаза 2: Уточнение вопроса
Спросите: «Что вы хотите узнать из этих данных?»
Предложите типичные отправные точки:
- (a) Обзор — как данные выглядят в целом?
- (b) Тренды — что изменилось со временем?
- (c) Факторы — что влияет на конкретную метрику?
- (d) Аномалии — что необычного или неожиданного?
- (e) Сравнение — чем отличаются группы?
- (f) Прогноз — чего ожидать дальше?
- (g) Другое — пользователь описывает сам
Не запускайте все возможные анализы. Запускайте только то, что отвечает на вопрос.
Фаза 3: Анализ
См. METHODS.md для конкретных методик.
На каждом шаге анализа:
- Сформулируйте, что вы собираетесь сделать и почему: «Я проверю, есть ли у выручки сезонная закономерность, потому что вы упомянули, что она колеблется»
- Покажите результат с цифрами
- Переведите на простой язык: «Это значит, что ваша выручка стабильно падает на 15-20% в Q1 каждый год»
- Раскройте следствие: «Так что при планировании денежного потока закладывайте дефицит в Q1 и планируйте резервы»
- Спросите: «Хотите копнуть глубже?» или «Посмотрим с другой стороны?»
Фаза 4: Синтез
После завершения всего анализа:
- Начните с заголовка — одно предложение, отражающее самую важную находку
- Подкрепите 2-3 ключевыми находками — каждая полным предложением с цифрой И её смыслом
- Отметьте ограничения — чего данные не могут рассказать, сомнения в размере выборки, нехватка контекста
- Порекомендуйте действия — 1-2 конкретных шага, которые пользователь должен предпринять на основе находок
- Предложите дополнительные данные — какие данные укрепили бы выводы
Правила простого языка
Это обязательно. Каждое число должно быть переведено.
| Статистический термин | Простой язык |
|---|---|
| «p < 0.05» | «Менее 5% вероятности, что эта закономерность — совпадение» |
| «r = 0.8» | «Сильная положительная связь — когда одно растёт, другое тоже склонно расти» |
| «медиана» | «Серединное значение — половина выше, половина ниже» |
| «стандартное отклонение» | «Насколько разбросаны значения. Большинство укладываются в [X] от среднего» |
| «корреляция не означает причинность» | «Они изменяются вместе, но одно может не вызывать другое. Может быть скрытый фактор» |
| «рост на 15%» | «Выросло с 200 до 230, то есть на 30 больше в месяц» |
Всегда давайте контекст для чисел:
- «340» — «По сравнению со средним 280 это выше нормы. Но ваш лучший месяц был 410, так что есть куда расти»
- «отток 5%» — «5 из каждых 100 клиентов уходят каждый месяц. При вашем масштабе (2000 клиентов) это 100 человек»
Формат вывода
## Анализ: [Тема]

### Заголовок
[Одно предложение — самая важная находка]

### Ключевые находки
1. [Находка с числом + смысл + следствие]
2. [Находка с числом + смысл + следствие]
3. [Находка с числом + смысл + следствие]

### Ограничения
- [Чего данные не могут рассказать]
- [Сомнения в размере выборки или качестве]

### Рекомендации
1. [Конкретное действие на основе находок]
2. [Конкретное действие на основе находок]

### Что помогло бы
- [Дополнительные данные, которые укрепили бы выводы]
Частые ошибки и как их избегать
- Корреляция как причинность — две переменные, движущиеся вместе, не означают, что одна вызывает другую. Называй это связью (ассоциацией), пока причинность не доказана.
- Крошечные выборки — не делай уверенных выводов о тренде из 3–5 точек. Помечай такие находки как предположительные.
- Cherry-picking — показывать выгодную метрику и прятать плоскую/негативную. Показывай полную картину.
- Молчаливое удаление выбросов — выбросы искажают результат; называй их и обосновывай любое удаление.
- Ложная точность — «улучшение на 42,37%» из зашумлённых данных — показуха. Округляй до обоснованной точности.
- Вывод без вопроса — анализ без решения, которому он служит, — это свалка данных. Привязывай находки к действию.
- Сокрытие неопределённости — говори, что данные не показывают, а не только что показывают.